为什么流光坚持本地AI?
01
AI很聪明,但你的照片更重要
每一张照片背后,都记录着真实的人生。
家人的面孔。
孩子的成长。
旅行的足迹。
生活中的点点滴滴。
对于 AI 来说,这些只是数据。
对于你来说,这些却是无法复制的回忆。
当照片被上传到云端分析时,你实际上交出了很多东西:
- 你的生活轨迹
- 你的家庭关系
- 你的社交圈
- 你的兴趣偏好
- 你的行为习惯
照片不仅记录你拍了什么。
更记录了你是谁。
02
人脸数据,是最特殊的数据之一
密码可以修改。
手机号可以更换。
银行卡可以注销。
但人脸不一样。
它是一种天然且无法更改的生物特征。
一旦泄露:
- 无法重置
- 无法撤销
- 无法重新生成一个新的自己
因此,对于照片管理产品而言:
最大的责任不是识别得多快。
而是保护得多好。
03
为什么很多AI产品需要上传照片?
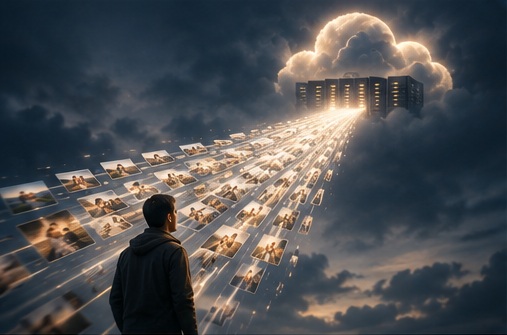
因为传统 AI 依赖云端计算。
通常流程是:
拍摄照片
↓
上传服务器
↓
服务器分析
↓
返回结果
这种方式的优点很明显:
- 模型更大
- 算力更强
- 更新更方便
但代价同样明显:
你的照片离开了自己的设备。
无论平台如何承诺安全。
数据的控制权都已经发生了转移。
04
流光选择了另一条路
流光坚持:
AI 在本地运行。
照片留在本地。
视频留在本地。
人物识别在本地完成。
地点整理在本地完成。
回忆生成在本地完成。
整个过程:
- 无需上传照片
- 无需上传视频
- 无需建立个人影像数据库
你的数据始终停留在自己的设备中。
05
最安全的数据,是从未离开过设备的数据
今天,大多数隐私保护方案都在讨论:
- 如何加密传输
- 如何加强权限管理
- 如何规范服务器访问
这些都很重要。
但流光更关注另一件事:
如果数据根本不上传呢?
不上传,意味着:
- 不存在云端照片库
- 不存在远程分析记录
- 不存在第三方访问风险
- 不存在服务器泄露问题
减少暴露面,本身就是最有效的安全策略。
06
本地AI不仅是隐私,也是数字主权
很多人认为隐私保护只是技术问题。
实际上,它更像是控制权问题。
谁拥有照片?
谁掌握数据?
谁决定如何使用这些内容?
对于流光来说,答案始终是:
用户自己。
你的照片属于你。
你的回忆属于你。
你的家人属于你。
而不是任何平台。
AI应该成为帮助用户整理回忆的工具。
而不是获取数据的理由。
07
流光希望建立的是信任,而不是依赖
我们希望用户使用流光时,不需要担心:
- 照片会不会被上传?
- 人脸数据会不会被存储?
- 家庭影像会不会被用于训练模型?
因为这些问题从设计之初就已经被解决。
流光不依赖云端分析。
不依赖远程识别。
不依赖集中式照片数据库。
AI只是工具。
回忆才是主角。
08
因为你的回忆,本就应该掌握在自己手中
照片不仅是数据。
它们记录着人生。
记录着陪伴。
记录着成长。
记录着那些无法重来的瞬间。
我们相信:
最好的照片管理,不是让更多人看到你的照片。
而是帮助你更好地保存自己的回忆。
所以流光选择本地AI。
不是因为这是更容易的路。
而是因为这是更值得坚持的路。
因为你的回忆,
本就应该掌握在你自己手中。